[PostgreSQL]pg_stat_statements 뷰를 조회하여 디스크/메모리 버퍼를 과도하게 사용(I/O 부하 유발)하는 쿼리들을 상위 순위로 추출방법 및 실행계획 튜닝
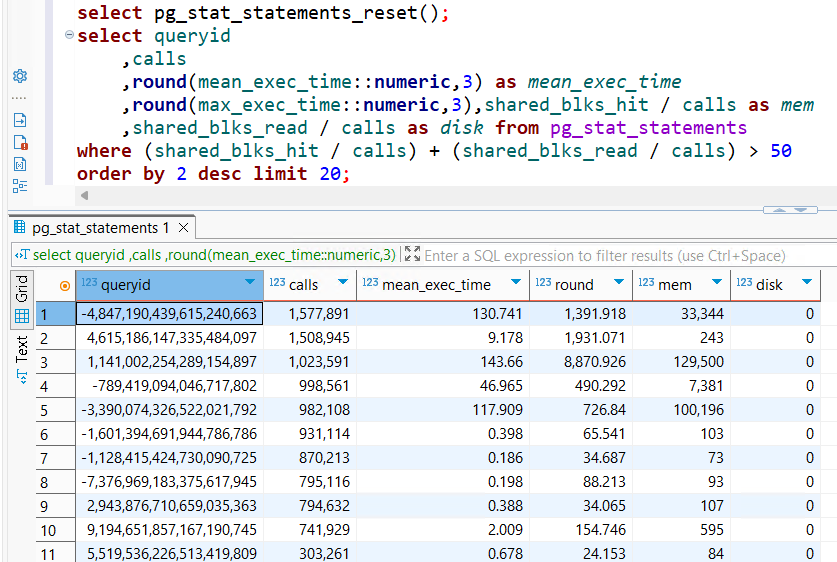
다음 첨부된 스크린샷 이미지는 pg_stat_statements 뷰를 조회하여 디스크/메모리 버퍼를 과도하게 사용(I/O 부하 유발)하는 쿼리들을 상위 순위로 추출한 결과 화면입니다.
1. 쿼리문 (SQL) 구조 분석
SELECT queryid
     , calls
     , round(mean_exec_time::numeric, 3) as mean_exec_time
     , round(max_exec_time::numeric, 3) as max_exec_time
     , shared_blks_hit / calls as mem
     , shared_blks_read / calls as disk
FROM pg_stat_statements
WHERE (shared_blks_hit / calls) + (shared_blks_read / calls) > 50
ORDER BY 2 DESC
LIMIT 20;
- 목적: 호출 1회당 평균 메모리(shared buffer) 히트 수와 디스크 읽기 블록 수의 합이 50 블록을 초과하는 쿼리(I/O 헤비 쿼리)들을 필터링합니다. (1블록 = 보통 8KB이므로, 1회 수행당 최소 400KB 이상 메모리/디스크 공간을 뒤적거린 쿼리들입니다.)
- 정렬 조건 (
ORDER BY 2 DESC): 2번째 컬럼인calls(총 호출 횟수) 기준 내림차순으로 정렬하여, 부하가 큰 쿼리 중에서도 가장 자주 실행된 악성 쿼리들을 최상단에 노출했습니다. - ⚠️ 특이사항 (컬럼 가독성 문제):
round(max_exec_time::numeric, 3)부분에 별칭(Alias)을 지정하지 않아, 그리드 결과창의 4번째 컬럼 이름이 그대로round로 노출되고 있습니다.
2. 실행 결과 데이터 상세 분석 (Grid View)
🚨 1순위 쿼리 (queryid: -4,847,190,439,615,240,663) — 가장 시급한 개선 대상
- 호출 횟수 (
calls): 1,577,891회로 전체 결과 중 압도적 1위입니다. - 평균 실행 시간 (
mean_exec_time): 130.741ms로 매우 무거운 편입니다. 이 쿼리 하나가 누적으로 소모한 총시간만 해도 약 206,294초(약 57시간)에 달합니다. - 최대 실행 시간 (
round/ max): 최고 1,391.918ms (1.39초)까지 튄 적이 있습니다. - 메모리 버퍼 소모량 (
mem): 1회 호출당 평균 33,344 블록(약 260MB)의 메모리 버퍼를 읽었습니다. - 종합 평가: 자주 호출되는데 매번 수많은 메모리 블록을 풀스캔하듯 읽고 있어 데이터베이스 CPU와 Shared Buffer에 가장 심각한 부하를 주는 주범입니다. 반드시
queryid에 해당하는 실제 SQL을 확보해 인덱스 추가 및 튜닝을 진행해야 합니다.
⚠️ 2순위 쿼리 (queryid: 4,615,186,437,335,484,097)
- 호출 횟수 (
calls): 1,508,945회로 1위만큼 자주 호출됩니다. - 평균 실행 시간 (
mean_exec_time): 9.178ms로 단일 수행 속도는 빠릅니다. - 메모리 버퍼 소모량 (
mem): 1회 호출당 평균 243 블록(약 1.9MB)을 읽습니다. - 종합 평가: 1회당 부하는 적지만 워낙 자주 실행되어(150만 번) 누적 부하가 생긴 케이스입니다. 루프(Loop) 내에서 무분별하게 호출되고 있지는 않은지 애플리케이션 로직 검토가 필요합니다.
🔍 3순위 & 5순위 쿼리 (High Latency & High Memory)
- 3순위 (
queryid: 1,141...): 평균 시간이 143.66ms로 이 리스트에서 가장 느립니다. 건당 평균 메모리 블록도 129,500 블록(약 1GB)을 소모하여 데이터 셋을 통째로 메모리에 올려 읽는 대형 조인(Join)이나 대량 조회 쿼리로 추정됩니다. - 5순위 (
queryid: -3,390...): 평균 117.909ms, 회당 메모리 100,196 블록을 사용해 3순위와 유사한 형태의 무거운 쿼리입니다.
3. 주요 발견점 및 인프라 특징 (disk 값 = 0)
결과 테이블의 disk 컬럼이 모두 0으로 찍혀 있습니다.
이는 해당 쿼리들이 필요한 데이터를 디스크(HDD/SSD)에서 직접 읽어오지 않고, 100% PostgreSQL의 Shared Buffers(메모리 영역) 또는 OS 캐시에서 히트(Hit)하여 가져왔음을 의미합니다.
- 장점: 메모리에서 데이터를 처리했기 때문에 디스크 I/O 병목으로 인해 쿼리가 극단적으로 밀리는 현상은 방지했습니다.
- 단점(위험성): 악성 쿼리들이 메모리 버퍼를 수십만 개씩 과도하게 점유(Eviction 유발)하고 있기 때문에, 다른 중요한 쿼리들이 사용할 메모리 공간을 밀어내어 시스템 전반의 메모리 효율을 떨어뜨리고 있는 상태입니다.
4 .다음 단계 가이드 (To-Do)
1. 분석 결과를 바탕으로 아래 후속 조치를 취하는 것을 권장합니다.실제 SQL 텍스트 추출: 가장 심각한 1, 3, 5순위 queryid를 이용해 실제 실행된 쿼리문을 확인합니다.
SELECT query FROM pg_stat_statements WHERE queryid = -4847190439615240663; 2. EXPLAIN (ANALYZE, BUFFERS) 수행: 추출한 SQL 문 앞에 실행계획 확인 명령어를 붙여 실행해보고, Seq Scan(전체 스캔)이 발생하는 지점에 적절한 인덱스(Index)가 누락되었는지 확인합니다.
3. 실행 계획 핵심 문제 분석
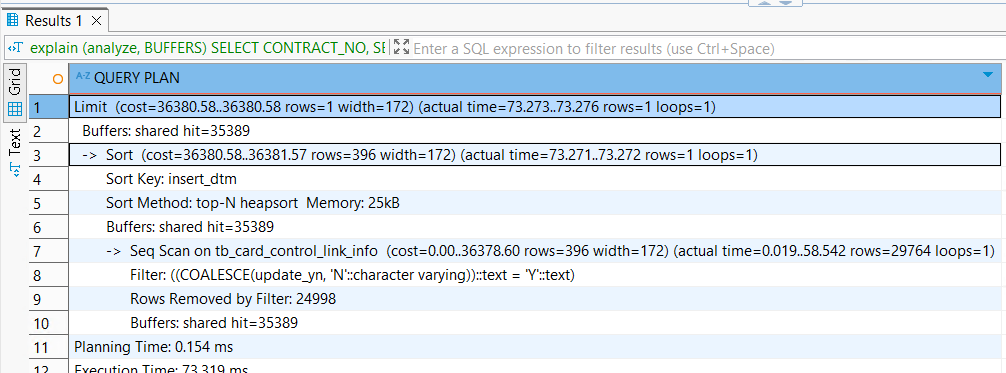
Seq Scan on tb_card_control_link_info(7번 줄)- 원인: 테이블의 전체 데이터(29,764건)를 인덱스 없이 처음부터 끝까지 무식하게 다 읽었습니다. 이 때문에 매번 35,389 블록(약 276MB)의 메모리를 뒤적거리게 되며 속도가 저하되었습니다.
Filter: ((COALESCE(update_yn, 'N'::...))::text = 'Y'::text)(8번 줄)- 원인: 전체를 다 읽은 후
update_yn값이 ‘Y’이거나 NULL인 데이터를 필터링하느라 24,998건을 메모리에서 버렸습니다(Rows Removed by Filter: 24998). - 🚨 치명적인 실수: 조건절에
COALESCE(update_yn, 'N') = 'Y'형태의 함수를 사용하셨습니다. SQL 조건절 좌변에 함수를 씌우면, 설령update_yn컬럼에 일반 인덱스가 걸려 있어도 데이터베이스는 인덱스를 타지 못하고 무조건 풀 스캔(Seq Scan)을 합니다.
- 원인: 전체를 다 읽은 후
Sort Key: insert_dtm/top-N heapsort(3~5번 줄)- 원인: 필터링된 데이터를 가져온 뒤,
insert_dtm컬럼 기준으로 메모리 정렬(Sort)을 시도했습니다. 정렬 후 딱 1건만 가져오기 위해Limit (rows=1)처리가 일어났습니다.
- 원인: 필터링된 데이터를 가져온 뒤,
4. 가장 완벽한 해결책 (인덱스 추가 및 쿼리 튜닝)
이 문제를 해결하려면 쿼리의 조건절 함수를 제거하고, 필터링과 정렬을 한 번에 처리할 수 있는 결합 인덱스를 하나 만들어야 합니다.
단계 1: SQL 쿼리 조건절 변경하기
COALESCE 함수를 걷어내고 PostgreSQL이 인덱스를 탈 수 있도록 일반 비교문으로 풀어 써야 합니다.
- 기존 조건절:
WHERE COALESCE(update_yn, 'N') = 'Y'
WHERE update_yn = 'Y' -- update_yn이 NULL이 아니고 'Y'인 데이터만 조회
(만약 update_yn에 진짜 NULL 값이 들어있고 그 NULL 값을 ‘N’으로 치환하려 하셨던 거라면, 어차피 우변이 'Y'이기 때문에 update_yn = 'Y'라고만 써도 결과는 100% 동일합니다.)
단계 2: 최적의 결합 인덱스(Composite Index) 생성하기
현재 세 번째 이미지에 보이는 인덱스들(contract_no, insert_dtm 등)은 이 쿼리의 WHERE 절 조건인 update_yn을 전혀 도와주지 못합니다.
데이터베이스가 update_yn = 'Y' 조건으로 빠르게 필터링한 후, 정렬 과정 없이 바로 insert_dtm 역순으로 한 건만 쏙 빼갈 수 있도록 아래 인덱스를 새로 생성해 주세요.
CREATE INDEX idx_tb_link_info_tuning
ON tb_link_info (update_yn, insert_dtm DESC);
정렬 방향 주의: 만약 쿼리문 끝이 ORDER BY insert_dtm DESC LIMIT 1 이라면 위와 같이 뒤에 DESC를 붙여서 인덱스를 만드는 것이 가장 좋습니다. (반대로 오름차순이면 DESC를 제외)
3. 조치 후 예상 결과
이렇게 인덱스를 잡고 쿼리를 수정하면, 다음 실행 시 Seq Scan과 Sort 단계가 통째로 사라지고 Index Scan 혹은 Index Scan Backward 단계로 바뀝니다.
- 소요 시간: 기존 73.319 ms ➡️ 1 ms 미만 (0.x ms)으로 단축
- 메모리 버퍼: 기존 shared hit=35389 ➡️ shared hit=3~5 내외로 극적인 감소
혹시 이 테이블의 update_yn 컬럼에 NULL 값이 실제로 존재하고, 그 NULL 값을 ‘Y’로 처리해야 하는 특수한 비즈니스 로직이 숨어있나요? 그렇다면 쿼리를 바꾸는 대신 부분 인덱스(Partial Index)나 함수 기반 인덱스(Expression Index)를 설계해야 하므로 대답해 주시면 맞춰서 변형해 드리겠습니다.
실행계획 :가장 추천하는 방법: EXPLAIN (ANALYZE, BUFFERS) 명령어 사용
#실행계획을 보자
EXPLAIN (ANALYZE, BUFFERS)
SELECT... --분석할 기존 쿼리 내용- 왜 이 옵션을 쓰나요?
ANALYZE: 쿼리를 실제 실행하여 예상치가 아닌 ‘실제 소요 시간’과 ‘실제 처리 행수’를 측정합니다. (CUD 쿼리 시 실제 데이터가 반영되므로 주의)BUFFERS: 앞서 리포트에서 보셨던 메모리 버퍼(Shared Blocks Hit)와 디스크 Read 수치를 실행 계획에 함께 표시해 주므로 튜닝할 때 필수적입니다.
- 결과 확인:
Text탭에 트리 형태로 실행 계획 결과가 출력됩니다.
🔍 실행 계획 결과에서 ‘이것’을 찾으세요!
결과창(텍스트 또는 트리)이 뜨면 가장 먼저 부하를 유발하는 다음 두 단어를 검색(Ctrl + F)해 보세요.
Seq Scan(Sequential Scan): 인덱스를 타지 못하고 테이블 처음부터 끝까지 통째로 읽었다는 뜻입니다. (여기에 인덱스를 걸어야 합니다.)Filter: 데이터를 다 읽어온 뒤에 메모리에서 걸러냈다는 뜻입니다. 인덱스 조건절로 흡수시켜야 하는 대상입니다.Actual RowsvsRows: Optimizer가 예상한 행수(Rows)와 실제 나온 행수(Actual Rows)의 차이가 너무 크다면 통계 정보가 꼬여있다는 의미입니다.
분석하시려는 쿼리가 SELECT가 아닌 INSERT / UPDATE / DELETE 쿼리인가요? 만약 그렇다면 ANALYZE 옵션 사용 시 데이터가 실제로 변경되므로 안전하게 테스트하는 법(트랜잭션 제어)을 추가로 안내해 드릴 수 있습니다.
INSERT, UPDATE, DELETE와 같이 데이터를 변경하는 쿼리에 EXPLAIN ANALYZE를 붙여서 실행하면, 실제로 데이터가 테이블에 삽입되거나 수정/삭제되어 버립니다.
따라서 운영 환경이나 실제 개발 데이터가 유지되어야 하는 상황에서는 반드시 트랜잭션(Transaction) 처리를 통해 테스트 후 데이터를 원상복구(Rollback)해야 합니다.
DBeaver에서 안전하게 실행 계획을 확인하는 2가지 방법을 안내해 드립니다.
방법 1. 🔒 명시적 트랜잭션 사용 (가장 추천)
쿼리 실행 전후로 BEGIN과 ROLLBACK을 감싸서 실행하는 방법입니다. 실행 계획 결과는 정상적으로 출력되지만, 실제 데이터는 저장되지 않고 취소됩니다.
BEGIN; -- 1. 트랜잭션 시작

EXPLAIN (ANALYZE, BUFFERS)
INSERT INTO target_table (col1, col2)
VALUES ('data1', 'data2'); -- 2. 분석할 INSERT 쿼리

ROLLBACK; -- 3. 중요!! 데이터를 반영하지 않고 무조건 취소
- 실행 방법: 위 블록 전체를 마우스로 드래그한 뒤,
Alt + X(DBeaver 스크립트 전체 실행)를 누릅니다. - 효과:
INSERT과정에서 인덱스 정렬, 제약 조건 체크 등으로 인해 소모된 실제 시간과 버퍼 수치를 안전하게 뽑아낼 수 있습니다.
🔍 INSERT 쿼리 실행 계획에서 중요하게 봐야 할 포인트
INSERT문인데도 실행 속도가 느리고 shared_blks_hit가 높게 나온다면 실행 계획 창에서 다음 항목들을 제어해야 합니다.
Subplan또는Function Scan:INSERT할 때VALUES에 서브쿼리가 들어가 있거나(e.g.SELECT max(id)+1), 기본값 생성을 위해 무거운 커스텀 함수가 내부적으로 호출되는지 확인합니다.Trigger: 테이블에AFTER INSERT나BEFORE INSERT로 동작하는 트리거가 심어져 있다면, 실행 계획 결과 맨 하단에 트리거가 소모한 시간(Trigger ...: time=XXXms)이 별도로 표기됩니다.- 인덱스(Index) 개수:
INSERT자체는 빠르지만 해당 테이블에 인덱스가 너무 많으면, 데이터를 넣을 때마다 모든 인덱스 트리를 재정렬하느라 속도가 급격히 느려집니다. (이는 실행 계획상의 시간 지연으로 나타납니다.)
[참고사항]
SELECT pg_stat_statements_reset(); 의미
SELECT pg_stat_statements_reset();은 PostgreSQL에서 쿼리 성능 모니터링용 확장 모듈인 pg_stat_statements가 수집한 모든 쿼리 통계 데이터를 즉시 초기화(0으로 리셋)하는 함수입니다.
쿼리를 튜닝한 경우, 인덱스를 추가한 경우, postgreSql 서버를 재시작한 경우 초기화해주면 좋겠죠? 새로 수집해야하니까요.
주요 특징 및 의미
- 카운터 초기화: 누적되었던 쿼리 호출 횟수(
calls), 총 실행 시간(total_exec_time), 블록 I/O 등의 모든 통계 지표가 전부 삭제되고 0부터 다시 기록됩니다. - 시스템 영향도 없음: 통계 데이터만 비우는 작업이므로 실행 중인 데이터베이스의 처리 성능이나 기존 데이터, 쿼리 동작에는 전혀 영향을 주지 않는 안전한 명령입니다.
- 실행 권한: 기본적으로 데이터베이스의 슈퍼유저(Superuser) 권한이 있어야 실행할 수 있습니다.
shared_blks_read / calls as disk 구문은 “쿼리가 1회 실행될 때마다 디스크(HDD/SSD)에서 평균적으로 몇 개의 블록(Block)을 읽어왔는가”를 계산하여 disk라는 이름의 컬럼으로 보여달라는 의미입니다.
각 부품의 상세한 의미와 가치는 다음과 같습니다.
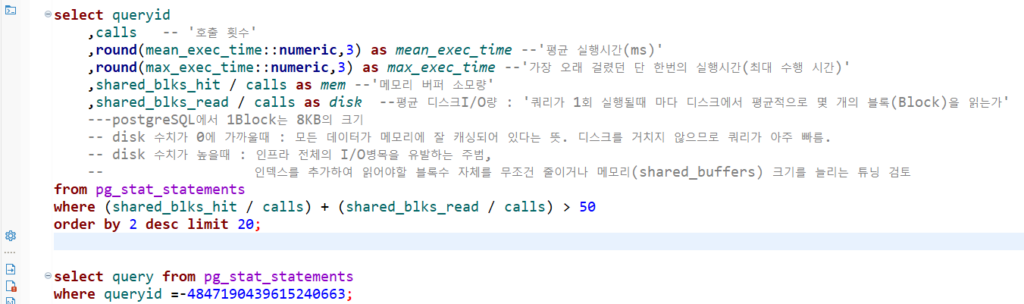
shared_blks_read / calls as disk 의미
1. shared_blks_read (누적 디스크 읽기 블록 수)
- PostgreSQL의 메모리 캐시(Shared Buffers)에 데이터가 없어서, 저장 장치(디스크)로부터 직접 읽어온 데이터 블록의 누적 총개수입니다.
- PostgreSQL에서 1블록은 기본적으로 8KB의 크기를 가집니다.
2. / calls (평균값 계산)
shared_blks_read자체는 데이터베이스가 켜진 이후(또는 리셋된 이후) 지금까지 누적된 총합입니다.- 이를 해당 쿼리의 총 호출 횟수인
calls로 나눔으로써, 쿼리가 딱 1번 실행될 때 소모되는 평균 디스크 I/O량을 구하게 됩니다.
3. as disk (컬럼 별칭)
- 결과 테이블 화면에서 알아보기 쉽도록 컬럼 헤더의 이름을
disk로 지정한 것입니다.
💡 튜닝할 때 이 수치가 왜 중요한가요?
disk수치가 0에 가까울 때:
모든 데이터가 메모리(Shared Buffers)에 잘 캐싱되어 있다는 뜻입니다. 디스크를 거치지 않으므로 쿼리가 아주 빠르게 동작합니다.disk수치가 높을 때 (주의 ⚠️):
쿼리를 실행할 때마다 느린 디스크 저장 장치에 매번 접근하고 있다는 뜻입니다. 인프라 전체의 I/O 병목을 유발하는 주범이 되므로, 인덱스를 추가하여 읽어야 할 블록 수 자체를 무조건 줄이거나 메모리(shared_buffers) 크기를 늘리는 튜닝을 검토해야 합니다.
예를 들어 disk 값이 1,000이 나왔다면, 쿼리가 1번 돌 때마다 디스크에서 약 8MB(1,000 * 8KB)의 데이터를 매번 긁어오고 있다는 의미가 됩니다.
앞서 개발 DB 실행 계획에서 보셨던 read=9326 수치가 바로 이 shared_blks_read에 해당합니다. 쿼리 1회당 약 73MB의 디스크 읽기가 발생했던 것인데, 수정한 쿼리와 새로운 인덱스를 적용한 후에는 이 disk 수치가 0 근처로 떨어졌는지 확인해 보셨나요?