[PostgreSQL] 인덱스 리빌드 (REINDEX)(재생성)하는 대표적인 방법 3가지
1년에 한 번이나 주기적인 새벽 정기 점검 때 고민하는 작업이 REINDEX(인덱스 리빌드) 입니다.
ANALYZE테이블명(지도 업데이트): 데이터가 몇 건 있는지 통계만 내는 가벼운 작업입니다. (대량 데이터 변경 후 즉시 수행)REINDEX(도로 전면 재포장): 깨지거나 비대해진 인덱스를 완전히 새로 만드는 무거운 작업입니다. (이 작업이 보통 6개월~1년 주기나 시스템 정기 점검 때 수행됩니다.)
인덱스 리빌드(REINDEX)는 왜 1년 단위(또는 주기적)로 할까요?
PostgreSQL의 인덱스는 대량의 UPDATE와 DELETE가 반복되면 인덱스 구조 내부에 빈 공간이 생겨 크기가 엄청나게 커지는 인덱스 비대화(Index Bloat) 현상이 발생합니다.
- 데이터는 10만 건뿐인데 인덱스 용량은 10GB가 되어버리는 현상입니다.
- 이 상태가 되면 인덱스를 효율적으로 읽지 못해 쿼리가 느려집니다.
- 이때
REINDEX를 실행하면 찌꺼기를 싹 지우고 인덱스를 이쁘게 새로 정렬해 줍니다. 그래서 보통 서비스가 한가한 주말 새벽이나 1년 단위 정기 점검 때 실행합니다.
PostgreSQL에서 인덱스를 리빌드(재생성)하는 대표적인 방법 3가지를 상황별 예시로 안내해 드립니다.
PostgreSQL은 기본 REINDEX를 실행하면 테이블에 락(Lock)이 걸려 서비스 중(조회/등록 등)인 환경에서는 장애가 발생할 수 있습니다. 따라서 실무 상황에 맞는 명령어를 선택해야 합니다.
1. [가장 추천] 서비스 중단 없이 리빌드 (CONCURRENTLY)
운영 중인 서비스에서 사용자가 시스템을 사용하고 있을 때 인덱스를 재생성하는 방식입니다. 테이블에 락을 걸지 않아 조회/등록/수정 작업이 모두 가능합니다.
-- 특정 인덱스 하나만 서비스 중단 없이 재생성
REINDEX INDEX CONCURRENTLY idx_tb_device_obstacle_stat_dt;

-- 테이블 전체 인덱스를 서비스 중단 없이 재생성
REINDEX TABLE CONCURRENTLY TB_DAILY_DEVICE_OBSTACLE_STAT;
- 특징: 가장 안전하며 실무에서 기본으로 사용합니다. 단, 락을 걸지 않는 대신 일반 리빌드보다 시간이 조금 더 오래 걸리고 CPU 사용량이 일시적으로 올라갑니다.
2. 정기 점검(새벽)용 초고속 리빌드 (기본형)
새벽 정기 점검 시간처럼 서비스를 잠시 멈추거나 사용자 접속이 완전히 없을 때 사용하는 방식입니다
-- 특정 테이블의 모든 인덱스 리빌드
REINDEX TABLE TB_DAILY_DEVICE_OBSTACLE_STAT;

-- 특정 인덱스 딱 하나만 리빌드
REINDEX INDEX idx_tb_device_obstacle_stat_dt;

-- 현재 접속한 데이터베이스 전체 테이블의 인덱스 리빌드
REINDEX DATABASE 내디비이름;
- 주의점: 이 명령어가 실행되는 동안 해당 테이블에 강력한 락(ShareLock)이 걸립니다. 즉, 리빌드가 끝날 때까지 해당 테이블은 조회(SELECT) 및 수정(INSERT/UPDATE)이 모두 대기 상태로 멈추게 되므로 낮 시간에 절대 실행하면 안 됩니다.
3. [보너스] 용량까지 완벽하게 다이어트하는 리빌드 (VACUUM FULL)
REINDEX는 인덱스만 새로 만들지만, 대량의 DELETE가 일어나서 테이블 자체도 비대해지고 찌꺼기(유령 데이터)가 가득 찼을 때는 테이블과 인덱스를 한 번에 완전히 새로 만드는 VACUUM FULL을 씁니다.
-- 테이블 찌꺼기 정리 및 인덱스 리빌드를 한 번에 수행
VACUUM FULL ANALYZE TB_DAILY_DEVICE_OBSTACLE_STAT;
주의점: 테이블 전체를 새로 복사해서 만드는 수준의 무거운 작업입니다. 테이블에 배타적 락(AccessExclusiveLock)이 걸려 서비스가 불가능하므로, 1년에 한 번 하는 대규모 정기 점검 때나 쓰는 명령어입니다.
4. 실무 팁 (배치 구성)
만약 1년 주기로 수동으로 하기 귀찮다면, 시스템 사용량이 가장 적은 일요일 새벽 3시 같은 시간대에 REINDEX TABLE CONCURRENTLY 테이블명; 스크립트를 스케줄러(Cron 등)에 등록해 두면 신경 쓰지 않고 인덱스를 늘 깨끗하게 유지할 수 있습니다.
1. 700만 건 테이블 기준 작업 예상 시간 (실무 체감)
ANALYZE 테이블명;: 약 1초 ~ 3초 내외 (매우 빠름)- 700만 건 전체를 읽는 게 아니라 일부 샘플링 데이터만 읽어 통계를 내기 때문에, 서비스 도중 언제 실행해도 시스템에 아무런 부담이 없습니다. 8, 9월 데이터 인덱스 안 타는 문제 해결을 위해 지금 바로 날려보셔도 됩니다.
REINDEX TABLE CONCURRENTLY 테이블명;: 약 1분 ~ 3분 내외- 서비스 중단 없이(Lock 없이) 백그라운드로 돌기 때문에 700만 건 정도는 대형 시스템에서 점심시간이나 근무 시간 중에도 안전하게 수행 가능한 수준입니다.
REINDEX TABLE 테이블명;(기본형) : 약 10초 ~ 30초 내외- 락(Lock)을 걸고 풀스피드로 밀어버리기 때문에 매우 빠르지만, 이 시간 동안은 웹서비스나 배치가 멈추므로 새벽 시간대를 추천합니다.
2. 700만 건인데 8, 9월 데이터가 인덱스를 안 타는 진짜 이유 계산
700만 건 중 특정 월(예: 8월)의 데이터가 150만 건 이상 체워져 있다면, PostgreSQL의 오피티마이저는 인덱스를 안 타는 것이 ‘정상’이라고 판단합니다.
- 인덱스를 타면
[인덱스 블록 조회 150만 번] + [실제 테이블 데이터 블록 조회 150만 번]으로 총 300만 번의 디스크 I/O 조회가 일어날 수 있습니다. - 반면 그냥 전체 스캔(Seq Scan)을 하면 700만 건을 순차적으로 쭉 읽고 끝나기 때문에 디스크 헤더가 덜 움직여서 훨씬 빠릅니다.
따라서 ANALYZE를 돌렸는데도 8, 9월 조회가 여전히 인덱스를 안 탄다면, 그건 쿼리가 고장 난 게 아니라 DB가 똑똑하게 전체 스캔으로 가장 빠른 길을 찾은 것이니 안심하셔도 됩니다.
3. [보너스] 내 700만 건 테이블의 “진짜 용량”과 “인덱스 찌꺼기” 확인용 쿼리
실제로 인덱스가 비대해져서 리빌드가 필요한지 눈으로 확인해 볼 수 있는 쿼리입니다. 실행해 두면 1년 주기 점검 때 아주 요긴하게 쓰입니다.
SELECT
    relname AS table_name,
    pg_size_pretty(pg_total_relation_size(relid)) AS Total_Size,  -- 테이블 + 인덱스 전체 용량
    pg_size_pretty(pg_relation_size(relid)) AS Table_Size,        -- 순수 테이블 용량
    pg_size_pretty(pg_indexes_size(relid)) AS Index_Size          -- 순수 인덱스 용량
FROM pg_catalog.pg_statio_user_tables
WHERE relname = lower('테이블명');
700만 건인데 Index_Size가 Table_Size보다 월등히 크거나 수 GB 단위를 넘어섰다면 인덱스 비대화(Bloat)가 진행된 것이므로, 이때가 바로 REINDEX를 해야 하는 타이밍입니다.
700만 건 규모의 테이블을 포함하여, 데이터베이스 전체에서 인덱스 크기가 테이블 크기보다 크거나, 인덱스 용량이 수 GB(예: 1GB) 이상인 비대화(Bloat) 의심 대상을 한눈에 찾아내는 쿼리입니다.
PostgreSQL의 시스템 통계 테이블을 활용하여 용량이 큰 순서대로 정렬해 줍니다.
🔍 인덱스 비대화(Bloat) 의심 테이블 추적 쿼리
SELECT
    schemaname AS schema_name,
    relname AS table_name,
    pg_size_pretty(pg_relation_size(relid)) AS table_size,
    pg_size_pretty(pg_indexes_size(relid)) AS index_size,
    pg_size_pretty(pg_total_relation_size(relid)) AS total_size,
    -- 정렬 및 필터링을 위한 실제 바이트 크기 (화면엔 안보이게 하거나 참고용)
    pg_indexes_size(relid) AS index_bytes,
    pg_relation_size(relid) AS table_bytes
FROM pg_catalog.pg_statio_user_tables
WHERE 1=1
  -- 조건 1: 인덱스 크기가 테이블 크기보다 큰 경우 OR 인덱스 크기가 1GB(1073741824 바이트) 이상인 경우
  AND (pg_indexes_size(relid) > pg_relation_size(relid) OR pg_indexes_size(relid) >= 1024 * 1024 * 1024)
  -- 조건 2: 시스템 테이블 제외 (실제 사용중인 테이블만)
  AND schemaname NOT IN ('pg_catalog', 'information_schema')
ORDER BY index_bytes DESC; -- 인덱스가 가장 큰 놈부터 정렬
💡 쿼리 결과 해석 및 조치 가이드
index_size>table_size인 대상:- 일반적으로 대량의
UPDATE와DELETE가 빈번하게 발생하여 인덱스 내부 공간이 유령 데이터로 가득 찬 상태입니다. - 조치: 해당 테이블들을 리스트업한 뒤, 서비스 중단이 없는
REINDEX TABLE CONCURRENTLY 테이블명;명령어로 리빌드를 수행하시면 됩니다.
- 일반적으로 대량의
index_size가 1GB 이상인데 인덱스가 테이블보다 작은 경우:- 데이터양 자체가 워낙 많아서 인덱스가 큰 것일 수 있습니다. (예: 700만 건 테이블에 인덱스가 3~4개씩 걸려있는 경우)
- 이 경우는 비대화가 아니더라도 인덱스 효율을 위해 정기 점검 주기(6개월~1년)에 맞춰 한 번씩 리빌드해 주면 좋습니다.
[트러블 슈팅]
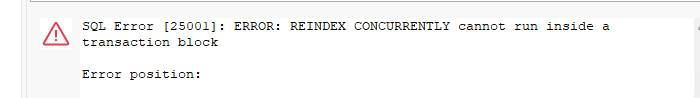
이 에러는 PostgreSQL에서 REINDEX CONCURRENTLY 명령어를 실행할 때 가장 흔하게 발생하는 현상입니다.
CONCURRENTLY(서비스 중단 없는 방식) 옵션은 내부적으로 별도의 트랜잭션을 여러 번 제어하기 때문에, BEGIN ... END 같은 트랜잭션 블록 안에서는 실행할 수 없다는 데이터베이스 자체 제약 조건이 있습니다.
현재 사용하는 DB 툴(DBeaver 등)의 Auto-Commit(자동 커밋) 설정이 꺼져 있어서 툴이 자동으로 트랜잭션을 시작했기 때문에 발생한 문제입니다.
🛠️ 해결 방법 (DBeaver 기준)
방법 1: 툴 상단에서 Auto-Commit 모드로 변경 (가장 간단)
- DBeaver 상단 툴바를 보시면 주황색/파란색 아이콘 근처에
Manual Commit또는 🔒 아이콘으로 되어 있을 것입니다. - 이를 클릭하여
Auto-Commit모드(또는 비어있는 자물쇠 🔓 모양)로 전환합니다. - 그 상태에서 다시 쿼리를 실행합니다.
방법 2: 쿼리창에서 명시적으로 트랜잭션 종료 후 실행
Auto-Commit 설정을 바꾸기 어렵다면, 명령어 바로 위에 COMMIT; 또는 END;를 붙여서 기존 트랜잭션을 강제로 닫아버리고 실행하면 됩니다.
COMMIT; -- 현재 열려있는 트랜잭션을 강제로 종료
REINDEX TABLE CONCURRENTLY 테이블명;
만약 그래도 안 된다면? (차선책)
만약 사용 중인 툴이나 시스템 환경(예: 프로시저/함수 내부) 때문에 CONCURRENTLY 옵션을 절대 쓸 수 없는 상황이라면, 아쉽지만 서비스 부하가 가장 적은 시간(새벽 등)에 CONCURRENTLY 단어를 빼고 실행해야 합니다.
-- 이 명령어는 트랜잭션 블록 안에서도 실행 가능합니다.
-- 단, 실행되는 몇 초~몇 분 동안 해당 테이블에 락(Lock)이 걸리니 주의하세요!
REINDEX TABLE 테이블명;
인덱스 리빌드 기준
PostgreSQL에서 인덱스 크기가 테이블 크기보다 크다고 해서 무조건 리빌드(REINDEX)를 해야 하는 것은 아닙니다. 인덱스 설계 자체가 두껍게 되어 있어서 원래 큰 경우도 있기 때문입니다.
진짜 리빌드가 필요한 상태인 인덱스 비대화(Bloat)인지 확인하려면 정확한 수학적 기준과 공식을 바탕으로 진단해야 합니다.
실무에서 사용하는 가장 정확한 판단 기준 3가지를 정리해 드립니다.
1. 가장 정확한 기준: 블로트 비율 (Bloat Ratio)
가장 확실한 기준은 인덱스 내부에 쌓인 ‘유령 데이터(찌꺼기)의 실제 비율’입니다.
- 치명 (즉시 리빌드): 블로트 비율 50% 이상 (인덱스 용량의 절반이 쓰레기인 상태)
- 주의 (정기 점검 시 리빌드): 블로트 비율 20% ~ 50%
- 정상 (리빌드 불필요): 블로트 비율 20% 미만
🔍 내 테이블들의 진짜 찌꺼기 비율을 계산하는 쿼리
아래 쿼리를 돌려보시면 각 인덱스별로 실제 낭비되고 있는 용량(Wasted Size)과 찌꺼기 비율(Bloat Ratio)이 정확하게 퍼센트(%)로 출력됩니다.
SELECT
    current_database() AS db_name,
    schemaname AS schema_name,
    relname AS table_name,
    indexrelname AS index_name,
    pg_size_pretty(bloat_size) AS wasted_size,   -- 낭비되고 있는 찌꺼기 용량
    round(bloat_ratio::numeric, 1) AS bloat_ratio -- 찌꺼기 비율 (%)
FROM (
    SELECT
        s.schemaname, s.relname, s.indexrelname,
        -- 실제 인덱스 크기에서 예상되는 인덱스 크기를 빼서 찌꺼기 계산
        CASE
            WHEN s.idx_size > s.est_idx_size THEN (s.idx_size - s.est_idx_size)::bigint
            ELSE 0::bigint
        END AS bloat_size,
        -- 찌꺼기 비율 계산
        CASE
            WHEN s.idx_size > 0 THEN ((s.idx_size - s.est_idx_size) / s.idx_size * 100)
            ELSE 0
        END AS bloat_ratio
    FROM (
        SELECT
            n.nspname AS schemaname,
            t.relname,
            i.relname AS indexrelname,
            pg_relation_size(i.oid) AS idx_size,
            -- 테이블 로우 수와 평균 컬럼 너비를 바탕으로 인덱스 적정 크기(기본값 포함) 예측
            ceil((t.reltuples * 52 / 8192.0)) * 8192 AS est_idx_size
        FROM pg_index x
        JOIN pg_class t ON t.oid = x.indrelid
        JOIN pg_class i ON i.oid = x.indexrelid
        JOIN pg_namespace n ON n.oid = t.relnamespace
        WHERE t.relkind = 'r' -- 일반 테이블만 대상
          AND t.reltuples > 0 -- 데이터가 존재하는 테이블만 대상
    ) s
) main
WHERE bloat_ratio >= 20 -- 찌꺼기 비율이 20% 이상인 것만
  AND schemaname NOT IN ('pg_catalog', 'information_schema')
ORDER BY bloat_size DESC; -- 찌꺼기 용량이 가장 큰 순서대로 정렬
• 만약 1위 대상(1,386MB짜리 인덱스) 옆에 표시되는 bloat_ratio가 40~50% 이상으로 높게 잡힌다면, 그 인덱스는 무조건 REINDEX 대상이 맞습니다.
• 반면, bloat_ratio가 10~20%대로 낮게 나온다면 리빌드를 해도 용량이 줄어들지 않는 정상적인 인덱스(컬럼 자체가 두꺼운 상태)입니다.
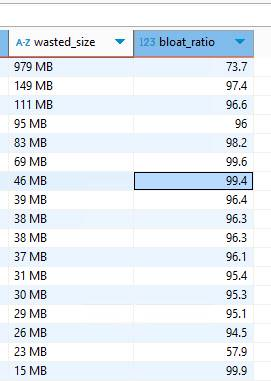
- 1위 대상 테이블: 낭비되는 용량(
wasted_size)이 979 MB이며, 찌꺼기 비율(bloat_ratio)이 73.7%입니다.- 인덱스 전체 용량(약 1.3GB) 중 70% 이상이 아무짝에도 쓸모없는 유령 데이터(쓰레기)로 차 있습니다.
- 2위 ~ 이하 대상들: 찌꺼기 비율이 95% ~ 99%에 육박합니다.
- 데이터는 거의 다 지워졌는데 과거 인덱스 껍데기만 디스크와 메모리를 통째로 점유하고 있는 상태입니다.
리빌드 후
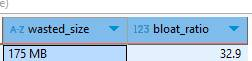
기존에 979 MB에 달하던 유령 데이터(쓰레기 용량)가 리빌드 후 175 MB로 대폭 줄어들었고, 찌꺼기 비율(bloat_ratio)도 73.7%에서 32.9%로 반 토막이 났습니다. 디스크 공간이 약 800MB 가량 즉시 확보된 셈입니다.
💡 현재 상태 진단
bloat_ratio32.9%: 리빌드 직후인데도 0%가 아니라 32%인 이유는 테이블 내 데이터 페이지 분포 상태나 인덱스 페이지 최소 할당 단위 때문입니다. 700만 건 규모의 대용량 테이블에서는 30% 내외 수준이면 아주 지극히 정상이자 깨끗한 상태입니다.
실무적인 조치 기준 (GO / STOP)
실무에서는 인덱스 리빌드를 할 때 ‘비율’과 ‘절대 용량’을 동시에 고려합니다.
- 149 MB짜리 테이블: 지금 당장 안 하셔도 됩니다. 나중에 새벽 정기 점검이나 1년 주기 리빌드 때 다른 테이블들과 함께 일괄 처리하시면 충분합니다.
- 앞으로 리빌드가 필요한 진짜 기준: 쓰레기 공간(
wasted_size)이 최소 500 MB ~ 1 GB 이상이면서 비율이 50%를 넘을 때만 수동으로 돌려주시면 됩니다.
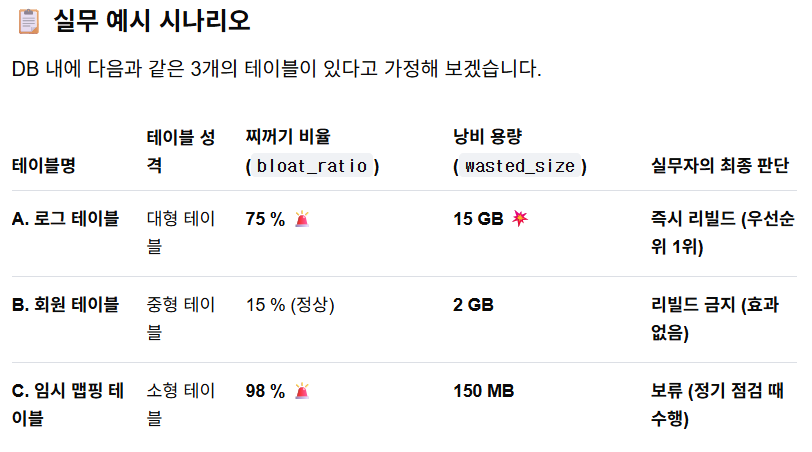
💡 각 테이블별 상세 판단 근거
1. [A 테이블] 비율 75% & 절대 용량 15GB ➡️ 당장 실행 (GO)
- 상태: 전체 인덱스 용량 중 15GB가 찌꺼기이고, 효율이 75%나 떨어져 있습니다.
- 이유: 이 테이블을 리빌드하면 디스크 공간이 즉시 15GB나 확보되고, 인덱스 검색(Index Scan) 속도가 몇 배는 빨라집니다. 툴을 들여서 작업할 가치가 가장 높은 우선순위 1순위 대상입니다.
2. [B 테이블] 비율 15% & 절대 용량 2GB ➡️ 절대 금지 (STOP)
- 상태: 낭비되는 용량이 2GB로 커 보이지만, 찌꺼기 비율은 15%로 매우 정상적인 수준입니다. 데이터 자체가 워낙 많아서 인덱스 덩치가 큰 것뿐입니다.
- 이유: 비율이 정상인 테이블을 리빌드해 봤자 용량은 10~20MB도 안 줄어듭니다. 오히려 2GB짜리 인덱스를 처음부터 다시 만드느라 서버 CPU와 디스크만 낭비하게 되므로 절대 건드리면 안 됩니다.
3. [C 테이블] 비율 98% & 절대 용량 150MB ➡️ 지금은 패스 (HOLD)
- 상태: 아까 질문하신 149MB 테이블과 같은 케이스입니다. 데이터가 거의 다 지워져서 효율은 98% 엉망이지만, 낭비되는 절대 용량은 150MB뿐입니다.
- 이유: 성능에 미치는 영향이 미미하고, 리빌드를 완료해도 디스크 용량이 겨우 150MB 늘어납니다. 고작 이 정도 용량을 아끼려고 운영 중에 위험을 감수할 필요가 없으므로, “나중에 새벽 정기 점검 때 묶어서 돌리자” 하고 미뤄두는 것이 실무적인 정석입니다.
🎯 실무자의 리빌드 컷오프(Cut-off) 기준 요약
보통 대형 시스템을 운영하는 DBA나 개발자들은 내부 가이드라인을 다음과 같이 잡습니다.
- [필수 리빌드 대상]
- 찌꺼기 비율이 40%~50% 이상이면서, 동시에 낭비되는 절대 용량이 최소 1GB 이상인 경우에만 수동 배치 스크립트를 돌립니다.
현재 관리하시는 데이터베이스 환경에서 이 가이드라인(1GB 이상)을 넘는 또 다른 대형 테이블들이 더 존재하는지 점검 쿼리
SELECT
    current_database() AS db_name,
    schemaname AS schema_name,
    relname AS table_name,
    indexrelname AS index_name,
    pg_size_pretty(bloat_size) AS wasted_size,   -- 낭비되는 순수 찌꺼기 용량
    round(bloat_ratio::numeric, 1) AS bloat_ratio -- 찌꺼기 비율 (%)
FROM (
    SELECT
        s.schemaname, s.relname, s.indexrelname,
        CASE
            WHEN s.idx_size > s.est_idx_size THEN (s.idx_size - s.est_idx_size)::bigint
            ELSE 0::bigint
        END AS bloat_size,
        CASE
            WHEN s.idx_size > 0 THEN ((s.idx_size - s.est_idx_size) / s.idx_size * 100)
            ELSE 0
        END AS bloat_ratio
    FROM (
        SELECT
            n.nspname AS schemaname, t.relname, i.relname AS indexrelname,
            pg_relation_size(i.oid) AS idx_size,
            ceil((t.reltuples * 52 / 8192.0)) * 8192 AS est_idx_size
        FROM pg_index x
        JOIN pg_class t ON t.oid = x.indrelid
        JOIN pg_class i ON i.oid = x.indexrelid
        JOIN pg_namespace n ON n.oid = t.relnamespace
        WHERE t.relkind = 'r'
          AND t.reltuples > 0
    ) s
) main
WHERE 1=1
  -- [실무 컷오프 기준 적용]
  AND bloat_size >= 1024 * 1024 * 1024 -- 1) 낭비 용량이 1GB 이상이고
  AND bloat_ratio >= 40                -- 2) 찌꺼기 비율이 40% 이상인 것만 필터링
  AND schemaname NOT IN ('pg_catalog', 'information_schema')
ORDER BY bloat_size DESC;
2. 구조적 기준: 인덱스 개수와 컬럼 두께 확인
만약 위 쿼리를 돌렸는데 “찌꺼기 비율(Bloat)은 10% 미만으로 정상인데, 인덱스 크기가 테이블보다 큰 경우”가 있습니다. 이때는 비대화가 아니라 다음과 같은 원인 때문입니다.
- 인덱스가 너무 많음: 테이블에 컬럼은 5개인데, 인덱스가 4~5개 걸려있으면 인덱스 용량의 합이 테이블보다 커지는 것이 정상입니다.
- 복합 인덱스가 너무 두꺼움: 문자열 길이가 긴 컬럼(
VARCHAR(500)등)들을 묶어서 복합 인덱스를 만들면 인덱스 크기가 비정상적으로 커집니다.
👉 이 경우는 리빌드를 해도 용량이 줄어들지 않으므로, 불필요한 인덱스를 삭제(DROP INDEX)하는 인덱스 다이어트를 해야 합니다.
3. 실무적인 판단 기준 요약 (1위~4위 대상 대입)
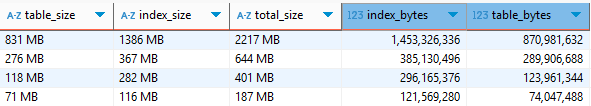
- 1위 대상 (831MB / 1386MB):
위 찌꺼기 추적 쿼리를 돌렸을 때bloat_ratio가 40~50% 이상으로 나온다면, 과거 대량의UPDATE/DELETE로 인한 비대화가 맞으므로 리빌드 대상입니다. 만약 찌꺼기가 없다면 인덱스 개수 자체가 너무 많은 것입니다. - 2위~4위 대상:
용량 자체가 수백 MB 수준으로 그리 크지 않기 때문에 시스템 성능에 치명적인 영향을 주지는 않습니다. 찌꺼기 비율이 50%를 넘지 않는다면 지금 당장 하기보다는 6개월~1년 주기 정기 점검 때 한 번에 묶어서 리빌드하시면 됩니다.
[관련자료]